

做 YouTube 街拍和 Vlog 的人大概都有同一个烦恼:镜头里总有路人。出于隐私和法律上的考虑,他们的脸要处理掉;但你自己、同行的拍摄者、受访者的脸又得留着。以前我是在剪辑软件里一个一个框、一帧一帧跟,一支十几分钟的视频能框掉一个下午。
所以我做了 FaceBlur:输入一段视频,自动找出画面里所有的脸,按「人」归好类,打开一个本地网页让我勾选「谁不用打码」,其余的人一律打码,最后输出和原片规格一致的成片。第二次起,它还记得我常出镜的朋友,自动预勾选。
这篇文章讲整体架构和关键实现细节,以及我在实测中踩到的坑。(整个工具是我和 Claude Code 结对一步步做出来的,下面所有数字都来自真实跑出来的结果。)
NOTE先说边界:这是一个「尽量少人工、但永远保留人工确认」的工具,不是 100% 保证。检测不到的脸(小脸、侧脸、背面、严重模糊)就是漏码,成片一定要抽查。后面的「局限」一节会具体说。
目标与约束
我给自己定了几条硬约束,后面的设计基本都是从这几条推出来的:
- 全程本地:视频里是别人的脸,不上传任何云服务,没有遥测、没有自动更新、没有运行期下载。
- 用上 Apple Silicon 的硬件:Mac mini M4 的 Neural Engine / GPU 做推理,VideoToolbox 做硬解硬编。所以不用 Docker——macOS 上的容器是个 Linux 虚拟机,里面根本摸不到 ANE、Metal 和 VideoToolbox。
- 输出规格不变:4K60 10-bit 的素材进去,分辨率、帧率、位深、色彩元数据、音轨都要原样出来;没打码的区域像素不能被动。
- 不确定就打码(fail-closed):漏打一个路人是隐私事故;误打一个朋友只是画质瑕疵,重渲染就行。所有默认值和异常处理都偏向打码。
- 环境可控:项目目录里一个 Python venv,ffmpeg 用本机已有的;不用 brew、不用 sudo、不改 shell 配置,想卸载删几个目录就行。
一张图看懂架构
FaceBlur 总体架构(点击图片在新标签页打开矢量大图,可无损放大)
整个系统分成两遍(Pass),中间用一组落盘的 JSON 衔接,网页只是在中间让人做决定:
- Pass 1 · 分析:每个视频只做一次。解码 → 检测 → 切镜头 → 跟踪 → 取脸算 embedding → 聚类 → 和 Gallery 比对。结果全部写进 sidecar 目录。
- Sidecar 与网页:
tracks.json(分析结果)、decisions.json(我的勾选和风格)、edits.json(手动校正)三份文件,加上缩略图和低清代理视频。网页只读写这几份文件。 - Pass 2 · 渲染:读取三份 JSON,生成逐帧的遮罩计划,硬解原片、只改人脸区域、硬编输出。改风格、改勾选、改校正,都只重跑这一遍,不用重新分析。
这样拆的好处很实际:分析最贵(要跑神经网络),所以只做一次;而「我想换个马赛克强度」「这个人其实要保留」这类操作,只需要重新渲染。
Pass 1:从视频到「人」
检测:SCRFD-10G + Core ML
检测用 SCRFD-10G(ONNX),直接用 onnxruntime 加载,解码和 NMS 自己写,不依赖 insightface 的 Python 包。关键在于让它真的跑在 Neural Engine / GPU 上:
providers = [ ("CoreMLExecutionProvider", { "ModelFormat": "MLProgram", "MLComputeUnits": "ALL", "RequireStaticInputShapes": "1", "ModelCacheDirectory": f"{ROOT}/cache/coreml", }), "CPUExecutionProvider",]Core ML EP 要求静态输入形状,所以我把动态形状的模型用 onnx 固定成几个尺寸(横屏 960×544、1280×736、1920×1088,竖屏对应转置)。静态之后,输出头的形状也要让 shape inference 重新推一遍,否则会留着过期的维度。
实测(M4,同一批真实人脸):
| 配置 | 检测单帧 | embedding 单张 | 相对 CPU 的精度 |
|---|---|---|---|
| CPU | 55.6 ms | 18.5 ms | 基准 |
Core ML ALL | 19.0 ms | 7.3 ms | 检测框 IoU 最小 1.000,embedding 余弦最小 1.0000 |
| Core ML 仅 GPU | 21.2 ms | 7.3 ms | 同上 |
| Core ML 仅 ANE | 36.7 ms | 13.6 ms | 同上 |
有意思的是:单用 ANE 反而比 GPU 混合慢,所以默认 ALL。精度也没有掉,所以不必回退 CPU。
检测精度档位:召回就是隐私
代理流(给检测用的缩小画面)的分辨率会直接决定能不能看到小脸。我拿一段 17 秒的 1080p 样本测了三档:
| 检测输入 | 用时 | 实时倍率 | tracks | 检测框 |
|---|---|---|---|---|
| 960 | 8.9 s | 1.9× | 177 | 1041 |
| 1280(默认) | 12.9 s | 1.3× | 224 | 1194 |
| 1920 | 20.8 s | 0.8× | 231 | 1300 |
960 最快,但漏掉了一位走过镜头的人;1280 和 1920 能找到。对打码工具来说,检测召回就是隐私召回,所以默认定在 1280,人群或远景可以手动切 1920。
TIP检测只负责「在哪里有脸」,找到的框坐标会换算回原始分辨率。渲染走的是另一条路(读原始分辨率的完整画面),所以检测用 1280 不会让 4K 成片变糊。
镜头切分与跟踪
跟踪用的是 ByteTrack,纯 numpy / scipy 自己实现:卡尔曼滤波预测框,IoU 做代价,匈牙利算法匹配;高分框先匹配,剩下的轨迹再和低分框做二次关联,这样脸被短暂遮挡时轨迹不容易断。
有一条规则我标成了最高优先级:镜头边界必须重置跟踪器。否则切点前后位置相近的两个不同的人会被缝成同一条 track,白名单就会错误地传播给陌生人。镜头切分用 PySceneDetect 的 ContentDetector,直接吃代理流的帧;我是先把整段的检测结果收集完,再按镜头分段做跟踪,这样不用担心检测器的切点会有延迟。
取脸、嵌入、聚类
对每条 track 先用一个质量分(人脸大小、检测分、yaw 估计、拉普拉斯清晰度加权)挑出 Top-6 帧,然后回到原始分辨率取脸——代理流上 20 像素的脸,原图上可能有 60 像素。取出的脸用 5 点关键点对齐成 112×112,交给 ArcFace(w600k_r50)算 512 维向量,按质量加权平均成这条 track 的 embedding。
为了不把整段 4K 都以全分辨率搬进 Python,取脸只在一个稀疏的帧网格上扫描(比如 30fps 素材每 4 帧一帧),用 ffmpeg 的 select 过滤器在解码端就丢掉不需要的帧。
聚类用 cosine 距离的层级聚类(average linkage),阈值 0.65。这里有两个有意的选择:
- 聚类阈值比识别阈值更宽松:宁可把同一个人拆成两个「人物」,也不能把两个人并成一个。拆开只是多点一下,并错会让路人被放行。
- 同一时刻同时出现的两条 track 一定是两个人:聚类之后检查,违反就强制拆开。
最后把总出现时长不足 1 秒、或者最大脸边长小于 32 像素的人物折叠到「其他(全部打码)」。
Pass 2:渲染
一帧的遮罩是怎么算出来的(点击图片在新标签页打开矢量大图,可无损放大)
在 YUV 平面上直接打码
渲染不经过 RGB。解码端直接输出源视频的原生 planar YUV,在内存里只改人脸所在的区域,再原样送给编码器:
# 解码:硬解,原位深直通ffmpeg -hwaccel videotoolbox -i src.mp4 -f rawvideo -pix_fmt yuv420p10le -fps_mode passthrough -
# 编码:另一个 ffmpeg 子进程从 stdin 读,同时从原片取音轨ffmpeg -f rawvideo -pix_fmt yuv420p10le -s 3840x2160 -framerate 60000/1001 -i - \ -i src.mp4 -map 0:v:0 -map 1:a? -c:a copy \ -c:v hevc_videotoolbox -allow_sw 0 -tag:v hvc1 -profile:v main10 -pix_fmt p010le这样做的好处有三个:10-bit 不会被降成 8-bit;S-Log3 / HLG 这类色彩空间不会被 RGB 转换弄偏;遮罩区域之外的像素在内存里逐位不变(测试里直接断言了这一点,8-bit 和 10-bit 各一遍)。-allow_sw 0 保证硬编不可用时直接报错,而不是悄悄退回很慢的软编然后假装成功。
渲染的最后一步也不让人放心:先写成 *.partial,再用 ffprobe 校验分辨率、像素格式、帧数,并完整解码一遍确认无错,全部通过才原子重命名成成品。任何一步失败,都不会留下一个「看起来完成了但其实没打码」的文件。
遮罩计划:一帧的遮罩怎么来
上图是渲染计划:每条 track 先稠密化——检测是每 2 帧一次,中间逐帧线性插值;首尾各外延 0.1 秒;再做一个约 0.12 秒的滑动平均抹掉抖动(所有时间参数都按秒配置、按帧率换算,24p / 30p / 60p 混用也不会出问题)。然后才是「这一帧要不要打码」的判定,以及手动遮罩、保留区这些人工校正的叠加。
判定规则是反着写的:只有 decisions.json 里明确写了 KEEP 的人物才不打码。缺失、UNCERTAIN、写错编号、没有归属,一律打码。
打码风格与「安全下限」
页面里我只保留了三种风格:高斯模糊、马赛克、贴图(后端还支持几种别的,但我自己不会用)。风格看起来是纯审美问题,但它直接关系到隐私,所以我给它加了一道硬性的「安全下限」:
即使是用户能选到的最弱一档,处理后的人脸区域也必须检测不出脸,或者与原脸的 ArcFace 余弦相似度低于 0.3。
这个「反识别回测」用真实人脸跑,渲染前自动执行(结果以 effects 源码、样本和模型做指纹缓存,代码一改就重跑)。不达标就拒绝渲染。
第一版的强度映射是凭直觉定的,结果回测直接打脸:
| 风格(最弱档) | 初版最大余弦 | 修正后 |
|---|---|---|
| 高斯模糊 | 0.535(不达标) | 0.214 |
| 马赛克 | 0.420(不达标) | 无人脸被检出 |
原因有两个:模糊/马赛克强度偏弱,以及羽化把五官放进了渐变区——羽化最大时全强度核心只有遮罩半径的一半。修正是:加强强度映射;羽化渐变带不允许侵入人脸区域;并把遮罩放大倍数的下限从 1.2 提到 1.4(1.2 时椭圆盖不住人脸框的四个角,头发和衣着会残留身份信息,同一个样本里纯黑块也有 0.26 的残留余弦)。
我还试做过一个「平均色块」(用脸部平均色填一块),回测余弦 0.338,超过了 0.3:一块肤色色块放在头发和衣服的上下文里,检测器照样觉得那是一张脸。所以这个风格被我直接放弃,没有提供。回测的价值就在这里——它能把「看起来很安全」的东西否掉。
记住常出镜的人:Gallery 与三态判定
Gallery 存的是人脸 embedding(生物特征数据,所以目录权限 700、文件权限 600、导出时会提示风险),每人最多保留 24 条模板,质量最低的先淘汰。
匹配时,对每个人物的每条 track 取它和某位已记住的人全部模板的最大相似度,再按 track 质量加权平均,然后分三态:
- ≥ 0.55 →
KEEP(预勾选) - ≤ 0.35 →
BLUR - 之间 →
UNCERTAIN(页面黄色高亮,未处理按打码渲染)
因为「误判 KEEP = 路人被放行」,我又加了两条保守规则:只要有一条 track 低于 0.35,即使加权平均很高也只给 UNCERTAIN(聚类阈值较松,可能把两人并成一个人物);最像的两位已记住的人相差不到 0.05,也只给 UNCERTAIN。
跨片段实测:把同一段素材切成前后两半,在前半段记住 7 个人,处理后半段——同一位男士自动 KEEP(0.645,我对着缩略图确认是同一个人);另一位男士和一位女士只有 0.49 / 0.47,被判 UNCERTAIN,交给我确认;两位戴口罩的人被错配成前半段的别人(0.42–0.45),同样只是 UNCERTAIN。全程没有一个错误的 KEEP。代价是需要人工点几下,这是我愿意付的。
网页:把人放进回路
页面用 FastAPI + 一个原生 JS 单文件,没有构建工具链。三个视图:
- 主页:输入路径或浏览目录选视频,分析时显示进度,下面是「最近处理」。
- 审核页:按出现时长排序的人物列表,头像、出现时段(点一下就渲染那一段预览)、保留/打码开关、「记住此人」、按人物单独指定风格;右侧是风格面板和并排对比(用该人物真实的人脸缩略图,和正式渲染调用同一份效果代码,所见即所得)。
- 校正编辑器:渲染后如果发现漏打或误打,在这里逐帧修。
实际界面
下面是工具真实运行时的截图(用一段 10 秒的街拍素材跑出来的)。为了保护画面里路人的隐私,截图里的人脸缩略图和视频画面我额外做了模糊处理,本机路径和人名也做了遮盖——这个工具本来就是干这个的,总不能自己写文章时露馅。
主页:输入路径或浏览目录选视频;右侧「最近处理」里是已经分析过的视频,点「打开」秒开。
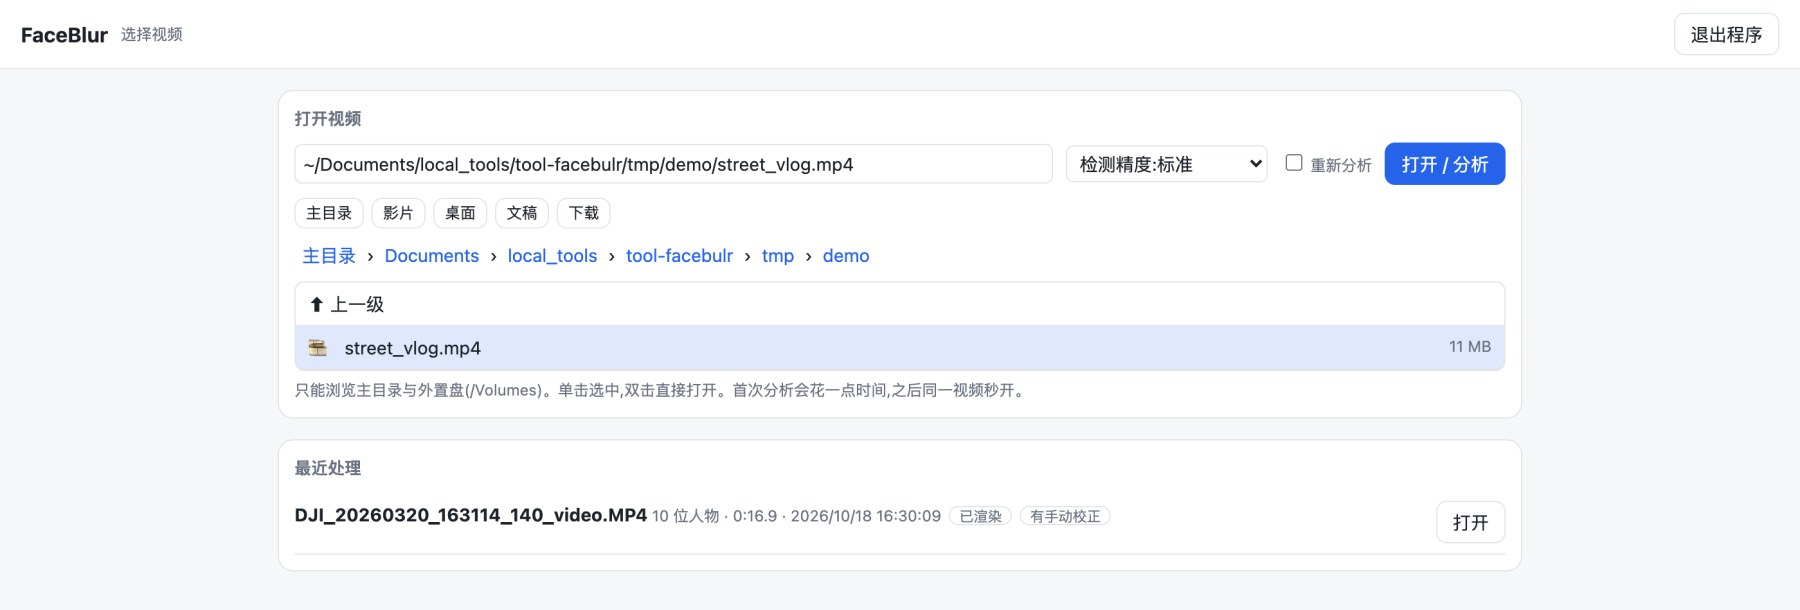
主页:选视频 · 目录浏览 · 最近处理
选好视频点「打开 / 分析」,顶部会出现进度条,按「检测 → 取脸 → 嵌入与聚类」分阶段汇报:
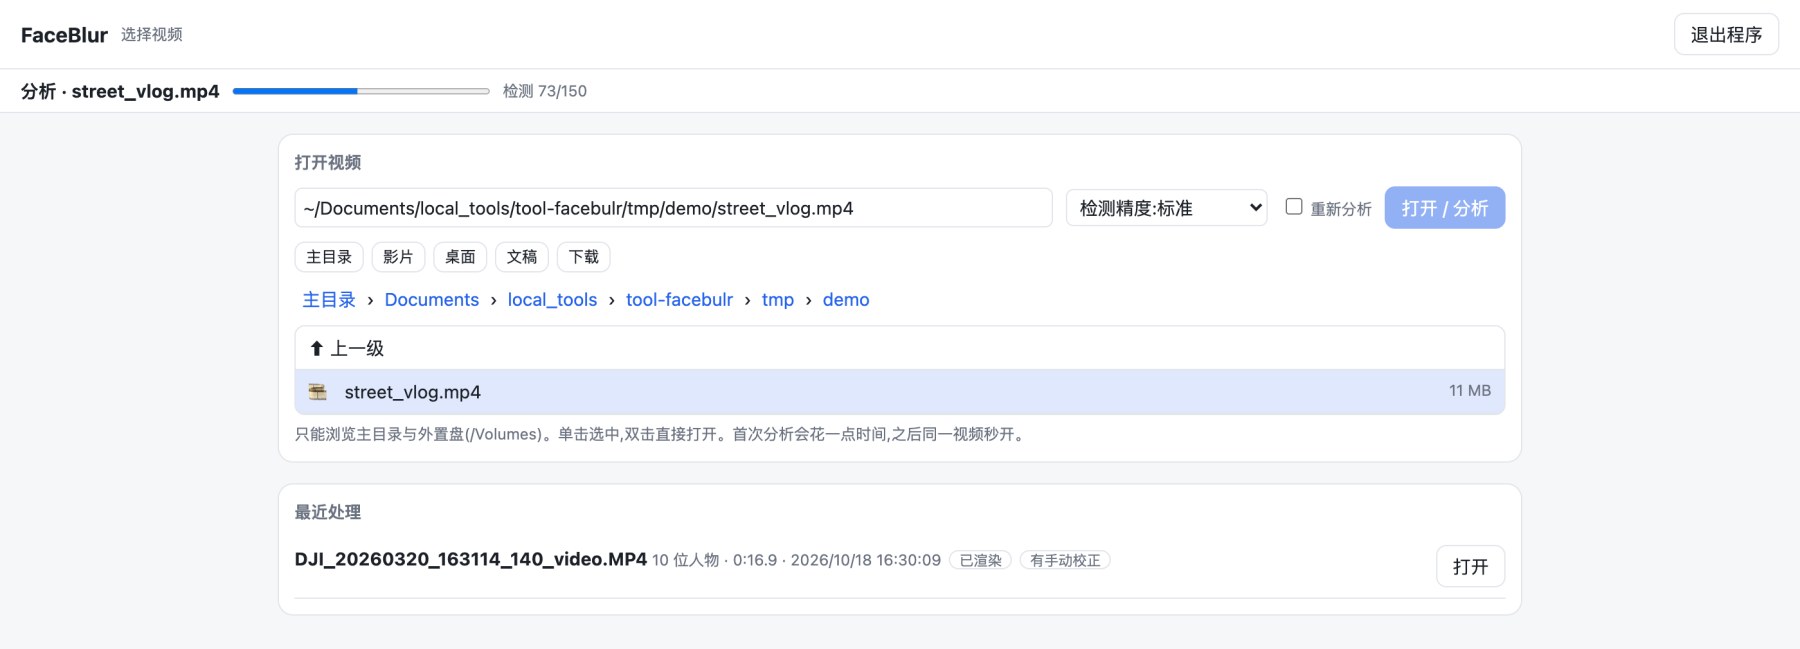
分析中:顶部进度条显示当前阶段和进度
审核页:左边是按出现时长排序的人物列表(头像、出现时段、保留/打码开关、「记住此人」输入框);右边是风格面板、预设,以及用该人物真实缩略图渲染出来的三种风格并排对比。截图里第一位人物和 p004 是保留状态,p004 旁边的绿色对勾是 Gallery 自动匹配并预勾选的结果;顶部黄色横幅提醒「自动预勾选需要你确认」。
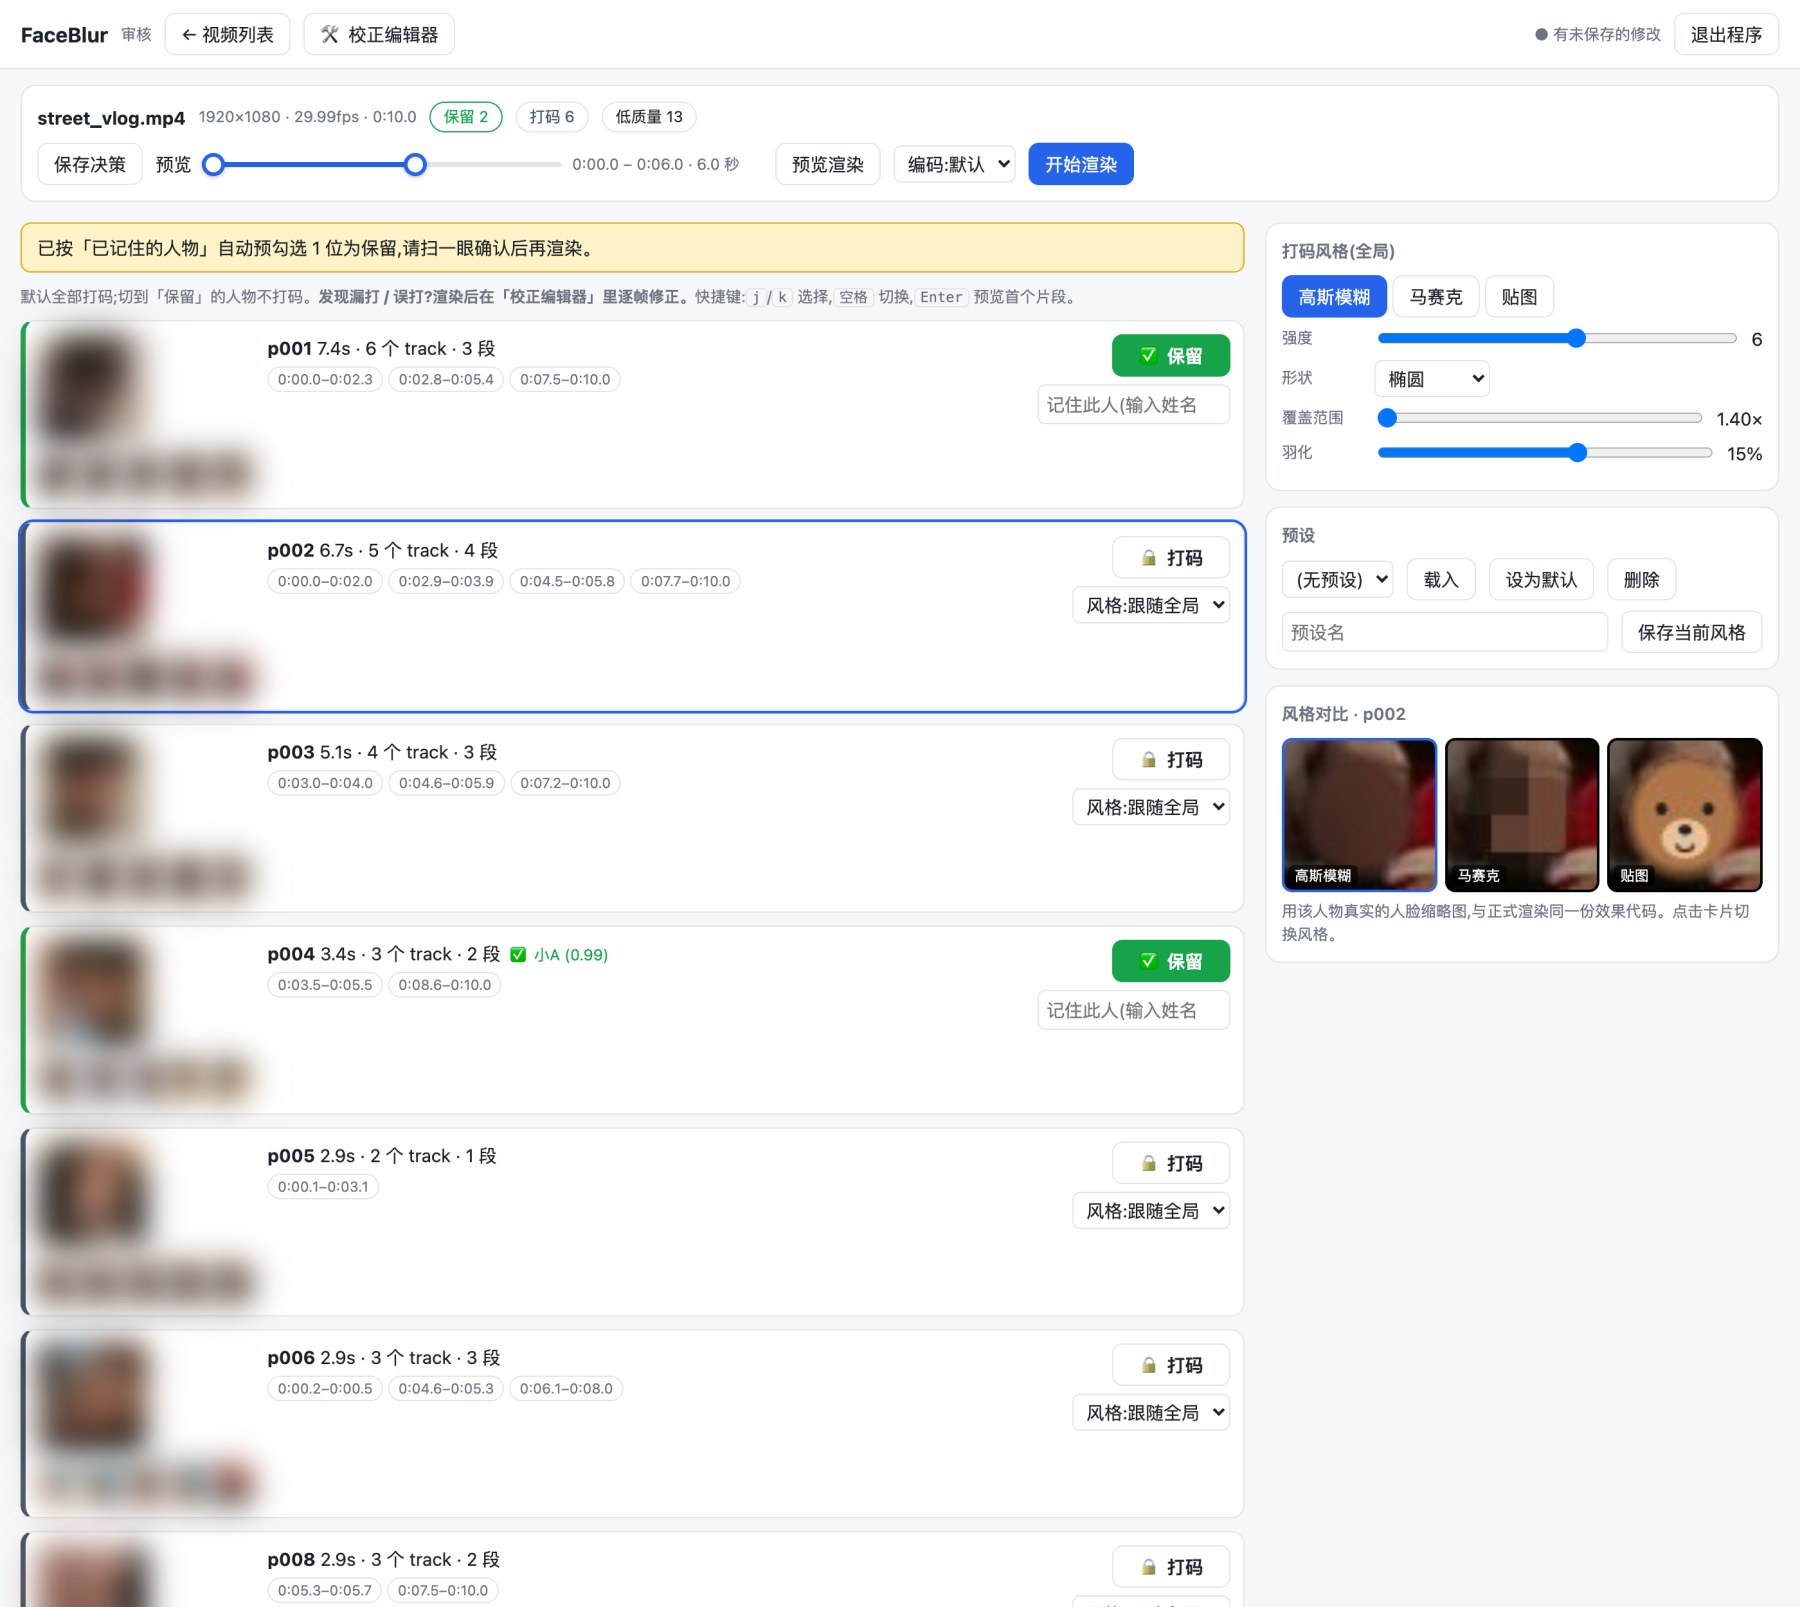
审核页:人物列表 · 风格面板 · 并排对比 · 预设
点「预览渲染」会用顶部的双端点滑块选定的区间渲染一小段,直接在页面里播放,并告诉你预览文件在哪、怎么在 Finder 里打开。预览固定用 H.264 小码率,只用来确认遮罩位置,画质低于最终成片:
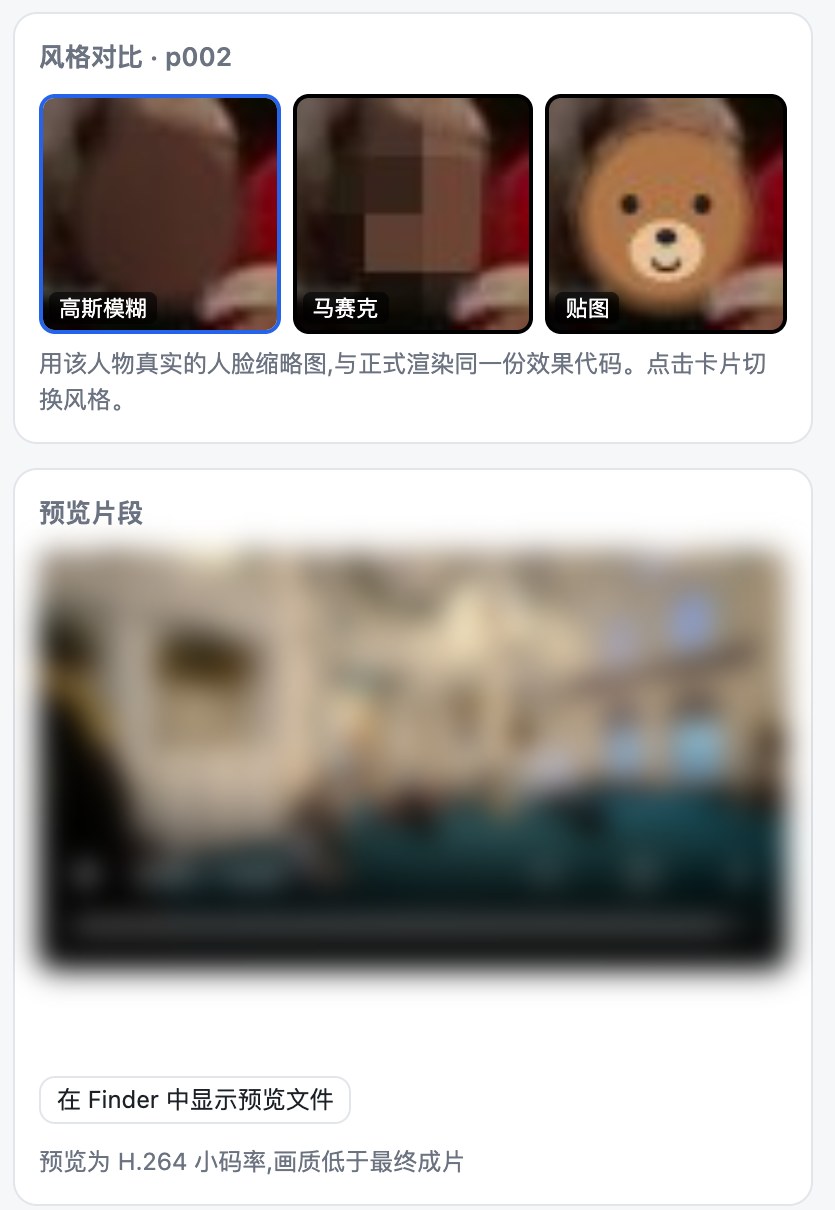
三种风格的并排对比(模糊 / 马赛克 / 贴图)与页内预览播放
校正编辑器
自动分析总会出错,所以我给它做了一个「事后修正」的入口。编辑器播放的是一个低清的 H.264 代理视频(几秒生成,只用来看),上面叠着覆盖层:红框是将被打码、橙色虚线是「检测丢了、靠延续撑出来的遮罩」、绿框是保留、蓝框是手动区域;底部时间线一眼看出哪一段有问题。
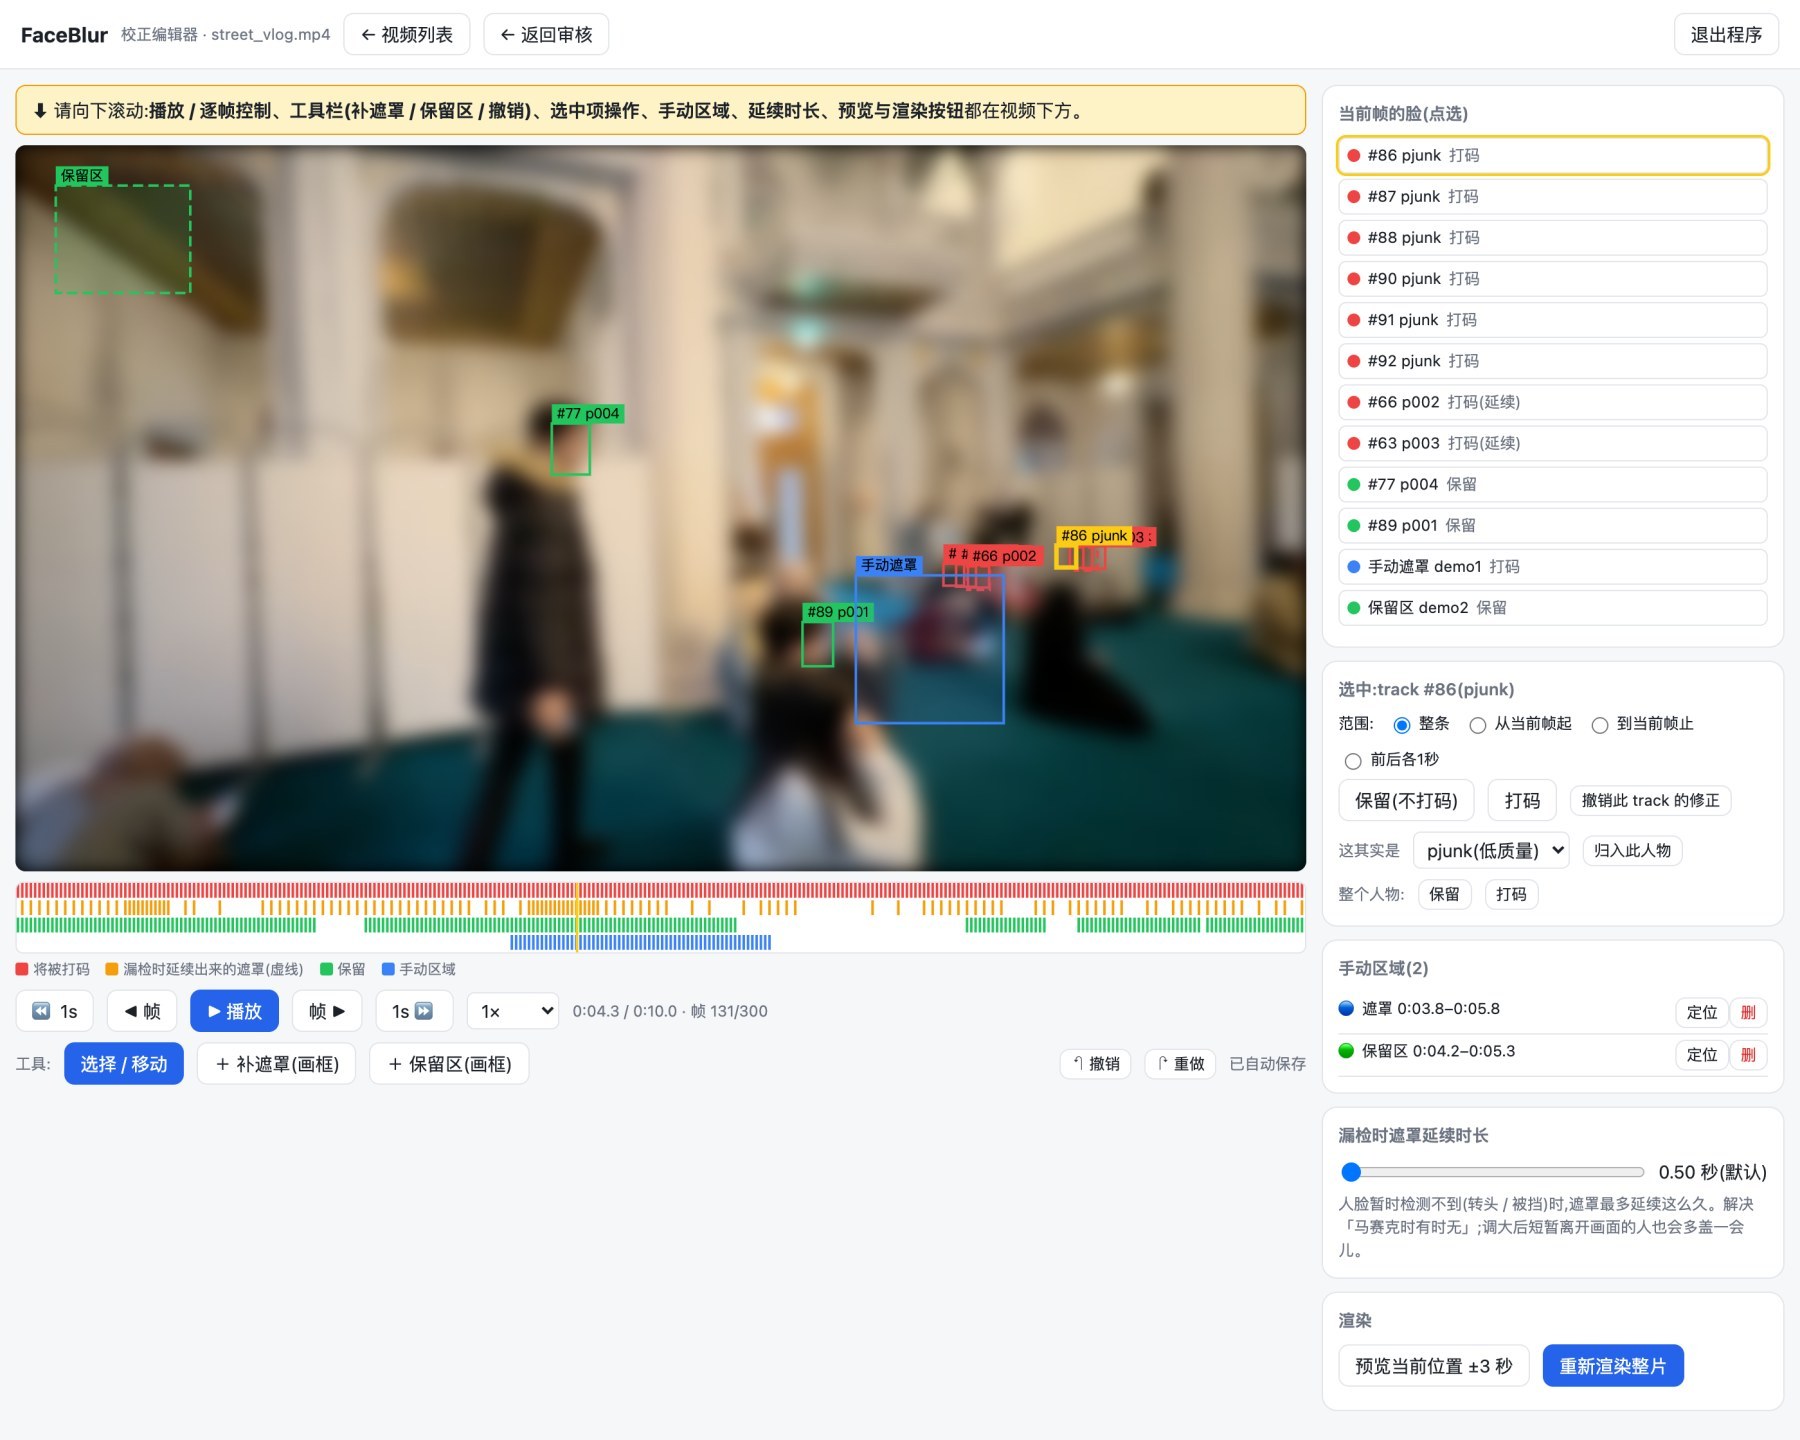
校正编辑器:逐帧覆盖层 · 时间线 · 选中项操作 · 手动区域(截图里的视频画面已额外模糊)
能做的修正:
- 点选一张脸,对这条 track 在「整条 / 从当前帧起 / 到当前帧止 / 前后各 1 秒」强制保留或打码;
- 「这其实是 pXXX」——把一条 track 归入另一个人物,修复同一个人被拆成几个人物;
- 在画面上拖框补遮罩(补漏)或加保留区(撤销误打码),框用关键帧 + 线性插值,换一帧再调一次就能跟着人移动;
- 「漏检时遮罩延续时长」滑块,解决「马赛克时有时无」。
所有修改自动写进 edits.json,支持撤销/重做。渲染时它们和 decisions.json 一起参与遮罩计划,渲染前同样做校验(损坏、版本不符、引用了不存在的 track,都拒绝)。
安全:本地不等于随便
虽然是本机服务,但页面能浏览目录、能触发渲染,所以做了几层防护:只绑定 127.0.0.1;启动时生成随机 token,首次访问换成 HttpOnly + SameSite=Strict 的 cookie,然后立刻重定向去掉地址里的 token;校验 Host 头(防 DNS rebinding)和 Origin 头,不开 CORS;文件浏览只能在主目录和外置盘下,只列目录和视频文件名,符号链接或 .. 穿出去的路径一律回退到根。这些都写成了测试(用真实的 uvicorn 加 http.client)。
踩过的坑
这一节是我觉得最值钱的部分。
1. 重新分析之后,人物编号会变。 我一开始只用 p001、p002 当人物标识,后来发现重新跑一遍分析,编号会重新排——旧的 decisions.json 里的 p002: KEEP 可能就指向了另一个人,等于把一个路人悄悄放行。修法是给每次分析一个 analysis_id,decisions.json 和 edits.json 都绑定它,不一致就直接拒绝渲染。
2. 「马赛克时有时无」的真正原因。 我原本以为是检测漏了,结果查下来那位男士每一帧都被检出了(置信度约 0.85)。问题出在:他的两条 track 之间有大约 1 秒的空档,而我写的「延续」逻辑只在单条 track 内部插值,同一个人的前后两条 track 之间不会被衔接。改成同一人物、同一镜头、空档不超过设定时长就线性过渡之后,同一个人的遮罩覆盖从 11.4 秒涨到 12.6 秒(延续 1.5 秒档)。剩下的空档都恰好落在镜头切换处,那是原理上衔接不了的,交给手动工具。
3. 别信旧文件。 有一次我对着一个成片诊断「主角被误打码」,查了半天,最后发现那个成片的修改时间比保存决策的时间还早——它根本是更早一轮测试的产物,不是按当前决策渲染的。教训:先对时间戳,再查算法。
4. 测试抓到一个越界。 文件浏览的目录列举,在路径非法时我把它回退到了「真实主目录」而不是「允许的根目录」。生产环境里两者重合所以暂时无害,但写测试时把根目录换成临时目录就暴露了。现在非法路径一律回退到受限根。
5. Core ML 的持续吞吐会掉。 embedding 单次测是 7 ms,但连续算近千张脸后降到约 17 ms,和 CPU 差不多(疑似持续负载下的降频)。好在分析只对每条 track 的 Top-K 帧算 embedding,量很小,不是瓶颈。如果要大批量,可以用我导出的 batch=8 版本。
局限与下一步
- 检测不到就是漏码。 小脸、侧脸、背面、严重模糊——这是整个方案的软肋。同一画面下 960 → 1920 多检出了约 25% 的框,下一步我打算做切块检测(SAHI 式),专门提升远景小脸的召回。
- 手动框是静态的,不做自动跟踪,要跟着人走得自己加关键帧。
- 镜头切换处的遮罩空档无法自动衔接,只能手动补。
- 4K60 10-bit 的完整渲染我还没有用真实素材跑过,目前只用合成素材测过一次硬解到硬编(5 秒素材约 0.9× 实时)。
- 模型许可: 默认的 SCRFD / ArcFace 权重来自 insightface,仅限非商业研究用途。我是个人、不盈利使用;如果将来频道变现,需要换成许可更宽松的模型(比如 OpenCV Zoo 的 YuNet / SFace)或重新评估授权。
技术栈速览
| 环节 | 选型 |
|---|---|
| 运行环境 | Python 3.14 venv · 本机 ffmpeg 9.x · 无 Docker、无 sudo |
| 解码 / 编码 | ffmpeg 子进程 + VideoToolbox(hevc_videotoolbox / h264_videotoolbox) |
| 检测 | SCRFD-10G(ONNX,静态形状,Core ML EP) |
| 跟踪 / 切镜头 | ByteTrack(自实现)· PySceneDetect |
| 识别 / 聚类 | ArcFace w600k_r50(512 维)· scipy 层级聚类 |
| 网页 | FastAPI · 原生 JS 单文件 · Canvas 覆盖层 |
| 数据 | pydantic v2 · JSON sidecar(带 analysis_id) |
| 测试 | pytest,157 项(单元、安全、集成) |
一个完整的自动打码流程,真正难的不是「把脸打上马赛克」,而是怎么在不确定的时候依然守住底线:默认打码、决策可追溯、出错就停手、给人留一个能修正的入口。这些东西加起来,才让我敢把它放进真实的剪辑流程里。